返回
MiniMax-H3 开源后,凭借视频生成能力迅速受到关注。
围绕这一模型,奥尼AI 从桌面工作站到 8 卡服务器,完成了两种算力形态的适配。
实际跑起来效果如何?下面直接看实测结果。
01
A2000 工作站:
最快约80秒,桌面也能跑H3
奥尼NeoFrog青跃桌面级工作站A2000,搭载NVIDIA Jetson Thor T5000芯片模组,拥有2070 TFLOPS 本地算力和128GB LPDDR5X 统一共享内存。
MiniMax-H3的原生工具链此前并没有针对这一硬件环境的适配方案。
奥尼AI 从底层入手:对 SageAttention 2 完成架构映射与 Dispatch 适配,并补齐其中缺失的 Kernel,先让 H3 在 A2000 上跑通完整生成链路。
跑通之后,再从三个方向继续提速:
降低注意力计算开销:优化 Attention 计算,让推理更快。
升级推理环境:结合编译优化,整体运行效率进一步提升。
压缩生成步骤:通过采样加速减少采样步数,缩短视频生成时间。
最终实测结果:
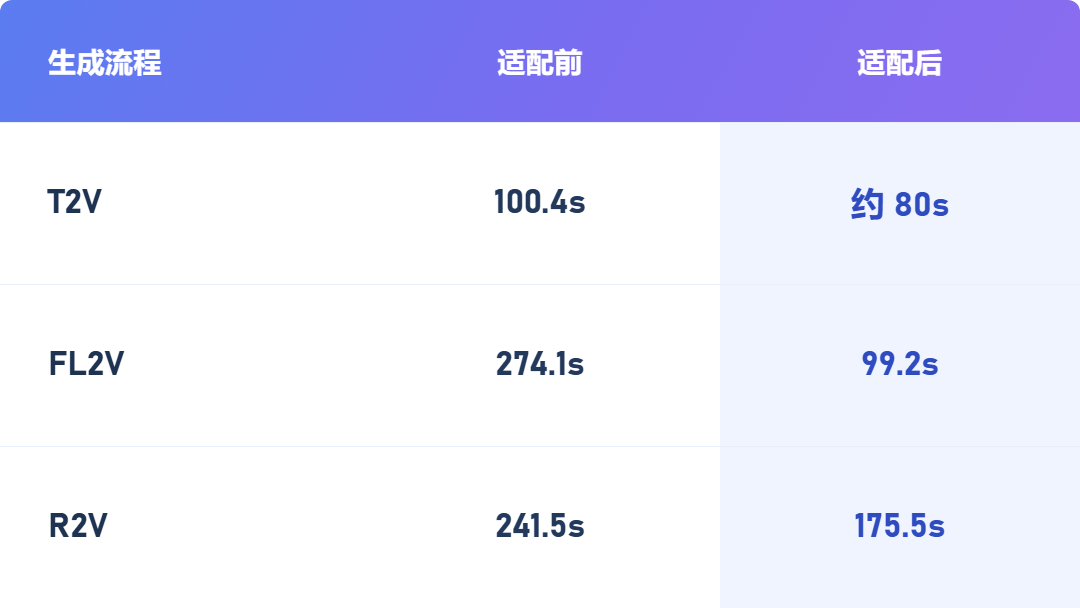
以 480P、5 秒、带音频的 T2V 任务为例,整机功耗约 140W,单条视频生成约 80 秒。
A2000视频效果
02
8 卡服务器:
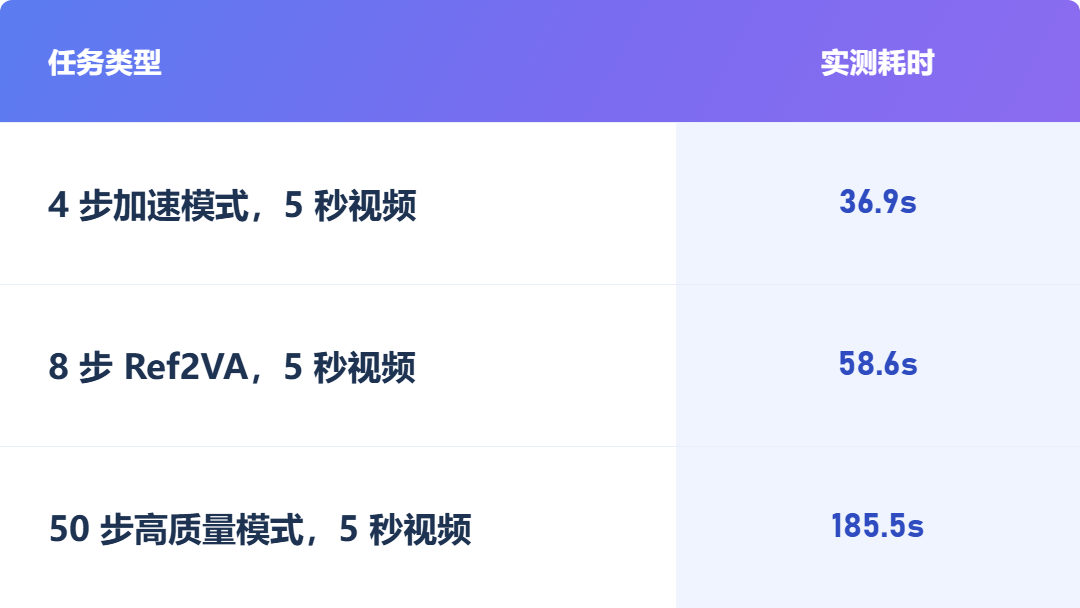
最快36.9秒,重点解决规模化运行
在搭载NVIDIA高性能GPU的8卡服务器上,奥尼AI 主要针对三件事做适配:长视频能不能跑、多张卡怎么配合、多个任务怎么同时排。
长视频生成:50 步长视频对显存占用要求更高,权重全部驻留显存很容易顶到上限。改为“DiT 权重常驻 + 文本编码器 / VAE Offload”、把部分组件移出显存后,10 秒、15 秒长视频都能稳定完成 50 步生成。
多卡运行:测试了不同的并行方式,TP4 在当前环境下延迟更低;TP8 的卡更多,但跨 NUMA 通信带来额外开销,反而更慢。
任务调度:把 8 张 GPU 划分为 4 个服务槽位,按任务类型、推理步数和视频时长进行分配,同时预留槽位承接长视频和临时增加的任务。
最终实测结果:
8卡服务器视频效果
同样是运行MiniMax-H3,不同的需求所适配的算力形态也不同。
对于需要轻量部署的创作场景,桌面工作站提供了更灵活的选择;面对更多视频生成任务,8卡服务器则提升了整体承载能力。
未来,奥尼AI将持续跟进新模型、新硬件与新架构,推进大模型在不同算力设备上的适配与优化,让AI推理能力从数据中心进一步走向桌面、边缘与企业本地部署场景。